스무 글자로 설명할 수 없는, 가장 작은 수
0. 서론: 한 문장이 부리는 마술
이 글에도 무서운 공식은 없습니다. 적분도, 행렬도, 낯선 그리스 문자도 거의 나오지 않습니다. 오늘 우리가 쓸 도구는 딱 두 가지뿐입니다. 하나는 초등학교에서 배운 세기, 곧 개수를 헤아리는 일이고, 다른 하나는 “말이 자기 자신을 가리킬 때 무슨 일이 벌어지는가” 를 한 발짝 떨어져서 들여다보는 눈입니다. 그러니 숫자만 보면 머리가 하얘지는 분이라도 오늘은 편하게 따라오셔도 좋습니다.
먼저 문장 하나를 읽어 보겠습니다. 급할 것 없으니 천천히 읽어 보세요.
스무 글자로는 설명할 수 없는 가장 작은 수.
별로 이상할 것 없어 보이지요. 세상에는 짧게 설명되는 수도 있고(“백만"이라든가 “구구단의 마지막 답"처럼) 한참 늘어놓아야 하는 수도 있을 테니, 그중에는 “스무 글자 안에는 도저히 담을 수 없는” 수들이 분명히 있을 겁니다. 그리고 그런 수가 있다면, 그것들 가운데 가장 작은 놈이 딱 하나 있겠거니 — 여기까지는 너무도 자연스럽습니다.
그런데 방금 그 수를 가리킨 문장, “스무 글자로는 설명할 수 없는 가장 작은 수” 를 띄어쓰기 빼고 한 글자씩 세어 보세요. 스(1)·무(2)·글(3)·자(4)·로(5)·는(6)·설(7)·명(8)·할(9)·수(10)·없(11)·는(12)·가(13)·장(14)·작(15)·은(16)·수(17). 딱 열일곱 글자, 스무 글자가 채 안 됩니다. 즉 우리는 방금, 스무 글자 안에는 설명할 수 없다던 바로 그 수를 열일곱 글자로 설명해 버렸습니다. 분명히 “스무 글자로는 설명 못 한다"고 못 박아 둔 수인데 말이지요.
이 작은 어지러움이 오늘의 주인공, 베리의 역설(Berry’s Paradox) 입니다. “이 문장은 거짓이다” 같은 자기 자신을 물어뜯는 문장들의 친척인데, 유독 음흉한 구석이 있습니다. 거짓말쟁이 문장은 누가 봐도 말장난처럼 생겼지만, 베리의 문장은 수와 개수라는, 세상에서 가장 또박또박한 것들로 멀쩡하게 차려입고 나타나거든요. 그래서 어디서 발을 헛디뎠는지 찾기가 더 어렵습니다.
오늘 우리는 이 한 문장을 끝까지 추궁해 볼 겁니다. 먼저 “그런 수가 정말 있기는 한가"부터 따져 보고(놀랍게도 있습니다), 그다음 도대체 어디서 모순이 비집고 들어왔는지를 장난감 언어 하나를 직접 만들어 손으로 짚어 보겠습니다. 그리고 마지막에는, 이 사소해 보이는 말장난이 사실은 “세상 거의 모든 수에는 짧은 이름이 없다” 는 충격적인 사실, 그리고 컴퓨터로도 풀 수 없는 한계와 곧장 이어진다는 것까지 보게 될 겁니다.
이 글의 파이썬 코드는 모두 접이식입니다. 코드가 부담스러우시면 펼치지 않고 그림과 숫자, 이야기만 따라오셔도 내용은 온전히 이어집니다.
1. 도서관 사서가 보낸 편지
이 역설에는 의외로 사람 냄새 나는 사연이 있습니다. 1900년대 초, 옥스퍼드 보들리 도서관(Bodleian Library) 에 G. G. 베리(G. G. Berry) 라는 사서가 있었습니다. 그가 당대 최고의 논리학자 버트런드 러셀(Bertrand Russell) 에게 편지로 수수께끼 하나를 보냈고, 러셀은 그것을 1906년 한 논문에 처음 활자로 옮기면서 — 그리고 1908년 더 유명한 논문 “유형 이론에 기초한 수리논리학"에서 다시 다루면서 — 각주에 정직하게 적어 둡니다.
“이 모순은 보들리 도서관의 G. G. 베리 씨가 내게 제안한 것이다.” (“This contradiction was suggested to me by Mr. G. G. Berry of the Bodleian Library.”)
수학사에 한 도서관 사서의 이름이 박히는 순간이었지요. (재미있게도, 러셀이 정리해 발표한 ‘글자·음절을 세는 정수 버전’과 베리가 편지에 적은 원래 형태는 사실 살짝 달랐다고 전해집니다. 베리의 원안은 우리가 다루는 보통의 정수가 아니라 무한의 영역에 있는 수, 곧 ‘유한개의 단어로는 이름 붙일 수 없는 첫 번째 서수(序數, ordinal)‘에 가까웠다고 하는데 — 그 이야기는 잠시 접어 두겠습니다.)
러셀이 1908년에 쓴 정식 문장은 이렇습니다. “열아홉 음절보다 적게는 이름 붙일 수 없는 가장 작은 정수.” 영어로 쓴 이 설명구 자체가 정확히 열여덟 음절이라, 열아홉 음절보다 적습니다. 그러니 열아홉 음절로는 이름 못 붙인다던 수를 열여덟 음절로 이름 붙여 버린 셈이지요. 우리가 서론에서 ‘글자’로 했던 장난을 러셀은 ‘음절’로 한 것뿐, 골격은 똑같습니다.
러셀은 한술 더 떠 그 수가 구체적으로 111,777 이라고 적어 두었습니다(영어식으로 이 수의 이름을 읽으면 마침 열아홉 음절이 필요하다는 계산입니다). 정확한 값이 무엇이냐는 사실 별로 중요하지 않습니다. 진짜 흥미로운 건, 이렇게 멀쩡한 정수를 가리키는 멀쩡한 문장이 어떻게 스스로를 부정하게 되는가 하는 점이니까요.
자, 그럼 추궁을 시작합시다. 가장 먼저 의심해 볼 것은 가장 기본적인 질문입니다. 그런 수가 애초에 존재하기는 할까요?
2. 그런 수가 정말 있기는 할까
역설을 만났을 때 가장 먼저 의심할 곳은 보통 “전제가 틀린 것 아닐까"입니다. “스무 글자로는 설명할 수 없는 수” 같은 게 정말 있기는 한가? 어쩌면 모든 수가 어떻게든 스무 글자 안에 욱여넣어져서, 그런 수는 아예 없는 것 아닐까?
아닙니다. 그런 수는 반드시 있습니다. 그리고 그걸 보이는 데에는 어려운 게 하나도 없습니다. 오직 세기만 쓰면 됩니다.
먼저 ‘설명한다’가 무슨 뜻인지부터 분명히 해 둡시다. 우리는 수를 1, 2, 3 같은 숫자로도 적지만, 말로 풀어서 부르기도 합니다. ‘백만’은 단 두 글자로 1,000,000을 가리키고, ‘구골’은 1 뒤에 0이 무려 백 개나 붙는 어마어마한 수를 역시 두 글자로 불러냅니다. 짧은 말 한마디가 이렇게 거대한 수도 콕 집어낼 수 있는 거지요. 베리의 문장에서 ‘설명’이란 바로 이것, 글자를 엮어 그 수를 가리키는 일입니다. 그러면 짧은 글자로 부를 수 있는 수가 과연 얼마나 되는지, 차분히 세어 봅시다.
이렇게 생각해 봅시다. 우리가 설명에 쓸 수 있는 글자가, 넉넉잡아 흔한 글자와 낱말이 한 천 가지쯤 된다고 칩시다. 그러면
- 한 글자짜리 설명은 많아야 천 가지,
- 두 글자짜리 설명은 많아야 천 곱하기 천,
- …
- 스무 글자짜리 설명은 많아야 천을 스무 번 곱한 수.
이 숫자들은 상상도 못 하게 크지만, 결정적으로 전부 유한합니다. 다 합쳐도 어떤 어마어마하게 큰, 그러나 끝이 있는 수에서 멈춥니다. 다시 말해 스무 글자 이하로 쓸 수 있는 서로 다른 문장은 (엄청나게 많아도) 개수가 정해져 있습니다.
그런데 수는요? 수는 1, 2, 3, … 하고 영원히 계속됩니다. 끝이 없습니다.
여기서 그 유명한 비둘기집 원리가 등장합니다. 이름표(설명 문장)는 유한개인데 이름을 붙여 줘야 할 수는 무한개라면, 아무리 알뜰하게 나눠 줘도 이름표를 못 받는 수가 반드시 남습니다. 그리고 이름 없는 수들이 있다면, 그중 가장 작은 수가 딱 하나 있겠지요(수에는 늘 ‘가장 작은 것’이 있으니까요). 바로 그 수가 “짧게는 설명할 수 없는 가장 작은 수”, 우리의 베리의 수입니다.
말로만 하면 못 미더우실 테니, 그림으로 확인해 봅시다.
파이썬 코드 보기 (펼치기 / 접기)
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.font_manager as fm
# 한글 차트용 폰트 자동 등록(윈도우=맑은 고딕). 없으면 라벨을 영어로 폴백(두부 방지, OS 이식성).
_has_kr, KFONT = False, "DejaVu Sans"
for _fp in [r"C:\Windows\Fonts\malgun.ttf",
            "/System/Library/Fonts/AppleSDGothicNeo.ttc",
            "/usr/share/fonts/truetype/nanum/NanumGothic.ttf"]:
    try:
        fm.fontManager.addfont(_fp)
        KFONT = fm.FontProperties(fname=_fp).get_name()
        plt.rcParams["font.family"] = KFONT
        _has_kr = True
        break
    except Exception:
        continue
plt.rcParams["axes.unicode_minus"] = False
def L(ko, en):
    return ko if _has_kr else en

DARK, LIGHT = "#0d1117", "#e6edf3"
BLUE, ORANGE, YELLOW, GREY, RED = "#5dade2", "#e08a3c", "#f1c40f", "#7d8590", "#e74c3c"

def style(ax):
    ax.set_facecolor(DARK)
    for sp in ax.spines.values():
        sp.set_color(LIGHT)
    ax.tick_params(colors=LIGHT, labelsize=10)
    ax.xaxis.label.set_color(LIGHT); ax.yaxis.label.set_color(LIGHT)

fig, (axL, axR) = plt.subplots(1, 2, figsize=(13, 6.0))
fig.patch.set_facecolor(DARK)

# (왼쪽) 실제 규모: 짧은 설명의 개수는 어마어마하게 크지만 '유한'하다
style(axL)
A = 1000                       # 흔한 글자/낱말이 약 1000가지라고 넉넉히 잡자
Ls = np.arange(1, 61)
log10_count = Ls * np.log10(A)   # log10(가능한 설명 수) ~= L * log10(A)
axL.plot(Ls, log10_count, color=BLUE, lw=2.6)
ATOMS = 80                       # 관측 가능한 우주의 원자 수 ~ 10^80
axL.axhline(ATOMS, color=GREY, ls=":", lw=1.6)
axL.text(2, ATOMS + 3, L("우주의 원자 수 (약 10^80)", "atoms in the universe (~1e80)"),
         color=GREY, fontsize=9.5)
for Lm in [20, 60]:
    y = Lm * np.log10(A)
    axL.scatter([Lm], [y], color=YELLOW, zorder=5, s=55, edgecolors=LIGHT)
    axL.annotate(L(f"{Lm}글자: 약 10^{int(y)}가지", f"{Lm} chars: ~1e{int(y)}"),
                 xy=(Lm, y), xytext=(Lm - 17, y + 9), color=LIGHT, fontsize=10,
                 arrowprops=dict(arrowstyle="-|>", color=YELLOW, lw=1.3))
axL.set_xlabel(L("설명에 쓰는 글자 수 (예산)", "description length (chars)"))
axL.set_ylabel(L("가능한 설명의 개수 (10의 지수)", "# possible descriptions (log10)"))
axL.set_title(L("이름표는 유한하다 (아무리 많아도)", "Labels are finite (however many)"),
              fontsize=12.5, loc="left", color=LIGHT)
axL.set_xlim(0, 61); axL.set_ylim(0, 190)

# (오른쪽) 작게 줄여 본 비둘기집: 이름이 모자라 미명명 수가 생긴다
style(axR)
a, Lb = 2, 4                     # 기호 2개, 길이 4 이하로 '작게 줄인' 예
S = a ** (Lb + 1) - a            # 서로 다른 문자열 수 = 2+4+8+16 = 30
ns = np.arange(1, 41)
axR.plot(ns, ns, color=BLUE, lw=2.4,
         label=L("수의 개수 (끝없이 늘어남)", "# integers (grows forever)"))
axR.hlines(S, 1, 40, color=ORANGE, lw=2.4, ls="--",
           label=L(f"≤{Lb}기호 이름의 총 개수 = {S}개", f"# names of ≤{Lb} symbols = {S}"))
axR.fill_between(ns, S, ns, where=(ns > S), color=RED, alpha=0.22)
axR.scatter([S + 1], [S + 1], color=RED, s=80, zorder=6, edgecolors=LIGHT)
axR.annotate(L(f"늦어도 {S+1}번째 수까지는\n이름이 바닥나\n'이름 없는 수'가 생긴다",
               f"by integer {S+1} at the latest,\nnames run out"),
             xy=(S + 1, S + 1), xytext=(17.5, 5.5), color=RED, fontsize=10.5,
             fontweight="bold", arrowprops=dict(arrowstyle="-|>", color=RED, lw=1.5))
axR.set_xlim(1, 40); axR.set_ylim(0, 40)
axR.set_xlabel(L("수 n", "integer n")); axR.set_ylabel(L("개수", "count"))
axR.set_title(L("작게 줄여 본 비둘기집", "The pigeonhole, scaled down"),
              fontsize=12.5, loc="left", color=LIGHT)
axR.legend(facecolor="#161b22", edgecolor=GREY, labelcolor=LIGHT, fontsize=9.5, loc="upper left")

print(f"흔한 글자가 {A}가지뿐이라 쳐도, 20글자로 만들 수 있는 서로 다른 문장: 많아야 약 10^60가지 (유한)")
print(f"60글자로 늘려도 약 10^180가지 — 우주의 원자 수(약 10^80)보다 많지만, 여전히 '유한'하다.")
print( "그런데 수 1, 2, 3, ... 은 무한히 많다.  유한개의 이름 < 무한개의 수")
print( "  => 짧은 이름을 못 받는 수가 반드시 남고, 그중 '가장 작은 수'가 존재한다 (= 베리의 수).")
print(f"작게 줄인 예: 기호 2개 · 길이 4 이하 -> 이름은 단 {S}개뿐.")
print(f"  => 1~{S+1} 안에 이미 '이름 없는 수'가 반드시 들어 있다.")

fig.suptitle(L("이름표는 유한, 수는 무한 — 그래서 '이름 없는 수'는 반드시 있다",
               "Finitely Many Names, Infinitely Many Numbers"),
             color=LIGHT, fontsize=15.5, fontweight="bold")
fig.tight_layout(rect=[0, 0, 1, 0.95])
plt.show()
흔한 글자가 1000가지뿐이라 쳐도, 20글자로 만들 수 있는 서로 다른 문장: 많아야 약 10^60가지 (유한)
60글자로 늘려도 약 10^180가지 — 우주의 원자 수(약 10^80)보다 많지만, 여전히 '유한'하다.
그런데 수 1, 2, 3, ... 은 무한히 많다.  유한개의 이름 < 무한개의 수
  => 짧은 이름을 못 받는 수가 반드시 남고, 그중 '가장 작은 수'가 존재한다 (= 베리의 수).
작게 줄인 예: 기호 2개 · 길이 4 이하 -> 이름은 단 30개뿐.
  => 1~31 안에 이미 '이름 없는 수'가 반드시 들어 있다.
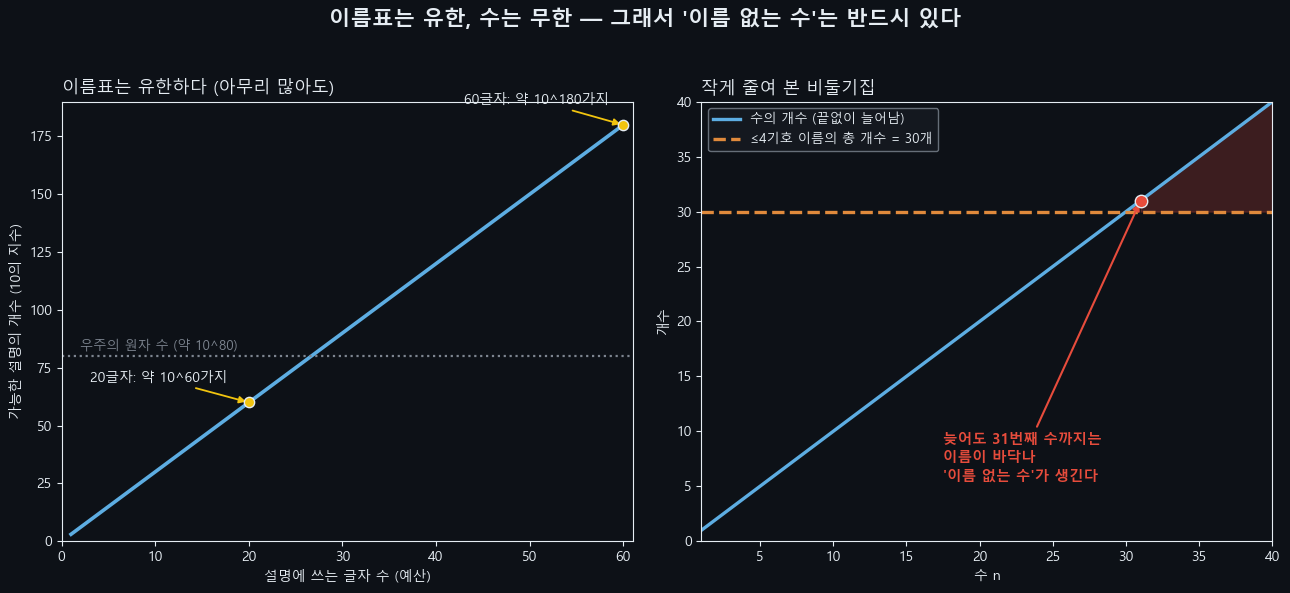
왼쪽 그림은 “짧은 설명이 몇 개나 가능한가"를 실제 규모로 그린 것입니다. 글자 수를 늘릴수록 가능한 문장 수는 무섭게 불어나서, 스무 글자만 돼도 약 10의 60제곱 가지, 예순 글자면 약 10의 180제곱 가지에 이릅니다. 관측 가능한 우주의 원자 수(약 10의 80제곱)마저 가볍게 뛰어넘는 천문학적인 수지요. 하지만 핵심은 그게 아무리 커도 끝이 있다는 것입니다. 위로 쭉 뻗어 가지만, 어느 높이에서든 그 값은 딱 정해진 유한한 수입니다.
오른쪽 그림이 결정타입니다. 천문학적인 수로는 눈에 안 들어오니, 일부러 작게 줄여서 “기호 두 개로, 네 글자 이하로만 이름을 짓는” 세상을 그렸습니다. 이 세상에서 만들 수 있는 서로 다른 이름은 모두 합쳐 딱 서른 개뿐입니다(주황 점선). 그런데 수는 파란 선을 따라 끝없이 늘어나지요. 둘이 만나는 지점을 넘어서면(붉게 칠한 영역), 붙여 줄 이름보다 이름을 기다리는 수가 더 많아집니다. 그러니 늦어도 서른한 번째 수에 이르기 전에, 이름표를 못 받은 수가 반드시 생깁니다.
이게 전부입니다. 알파벳을 천 가지로 늘리고 글자 예산을 스무 자로 키우면, “서른"이라는 숫자가 “10의 60제곱"으로 바뀔 뿐, 이야기는 한 글자도 안 달라집니다. 유한은 무한을 결코 다 덮을 수 없으니까요. 그러므로 “짧게는 설명할 수 없는 수"는 분명히 존재하고, 그중 가장 작은 수도 분명히 존재합니다.
자, 그러면 전제는 멀쩡합니다. 그 수는 진짜로 있습니다. 그렇다면 역설은 도대체 어디서 튀어나온 걸까요? 범인은 ‘존재’가 아니라, 그 수를 가리키는 방식에 숨어 있습니다. 이제 그 덫을 직접 만들어 보겠습니다.
3. 덫의 정체: 장난감 언어로 베리의 수를 잡아 보기
문제를 또렷하게 보려면, 흐물흐물한 일상 언어 대신 규칙이 딱 떨어지는 장난감 언어를 하나 만드는 게 최고입니다. 규칙은 이렇습니다.
숫자는 오직 1 하나만 쓸 수 있다. 거기에 더하기(+) 와 곱하기(×) 만 허락한다. 어떤 수를 “설명한다"는 건, 1들을 이 두 연산으로 엮어 그 수를 만들어 내는 것이다. 그리고 그 설명의 길이는 쓴 1의 개수로 잰다.
예를 들어 6은 이렇게 만들 수 있습니다.
6 = (1+1) × (1+1+1)
여기 쓰인 1은 모두 다섯 개니까, 이 장난감 언어에서 6의 “설명 길이"는 5입니다. 물론 1을 여섯 번 그냥 더해도(1+1+1+1+1+1) 6이 되지만, 그건 길이가 6이라 더 깁니다. 우리는 늘 가장 짧은 설명의 길이에만 관심이 있습니다. 이렇게 “어떤 수를 만드는 데 필요한 최소한의 1의 개수"는 수학자들이 실제로 연구하는 양이고, 정수 복잡도(integer complexity) 라는 이름까지 붙어 있습니다.
이 장난감 언어의 좋은 점은, 베리의 문장을 모호함 없이 던질 수 있다는 겁니다. “1을 열한 개로는 도저히 못 만드는 가장 작은 수"가 무엇인지, 컴퓨터에게 시켜서 정확히 찾아낼 수 있거든요. 일상 언어의 “설명 가능"은 두루뭉술하지만, 이 장난감 언어의 “만들 수 있다"는 칼같이 분명합니다. 직접 찾아봅시다.
파이썬 코드 보기 (펼치기 / 접기)
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.font_manager as fm
# 한글 차트용 폰트 자동 등록(윈도우=맑은 고딕). 없으면 라벨을 영어로 폴백(두부 방지, OS 이식성).
_has_kr, KFONT = False, "DejaVu Sans"
for _fp in [r"C:\Windows\Fonts\malgun.ttf",
            "/System/Library/Fonts/AppleSDGothicNeo.ttc",
            "/usr/share/fonts/truetype/nanum/NanumGothic.ttf"]:
    try:
        fm.fontManager.addfont(_fp)
        KFONT = fm.FontProperties(fname=_fp).get_name()
        plt.rcParams["font.family"] = KFONT
        _has_kr = True
        break
    except Exception:
        continue
plt.rcParams["axes.unicode_minus"] = False
def L(ko, en):
    return ko if _has_kr else en

DARK, LIGHT = "#0d1117", "#e6edf3"
BLUE, ORANGE, YELLOW, GREY, RED, GREEN = "#5dade2", "#e08a3c", "#f1c40f", "#7d8590", "#e74c3c", "#2ecc71"

def style(ax):
    ax.set_facecolor(DARK)
    for sp in ax.spines.values():
        sp.set_color(LIGHT)
    ax.tick_params(colors=LIGHT, labelsize=10)
    ax.xaxis.label.set_color(LIGHT); ax.yaxis.label.set_color(LIGHT)

def integer_complexity(N):
    """각 수를 1과 +,x 로 만드는 데 드는 최소 1의 개수 (OEIS A005245)."""
    comp = [0] * (N + 1)
    comp[1] = 1
    for n in range(2, N + 1):
        best = comp[1] + comp[n - 1]           # 1 + (n-1)
        for x in range(2, n // 2 + 1):         # 덧셈으로 쪼개기
            v = comp[x] + comp[n - x]
            if v < best:
                best = v
        x = 2
        while x * x <= n:                      # 곱셈으로 쪼개기
            if n % x == 0:
                v = comp[x] + comp[n // x]
                if v < best:
                    best = v
            x += 1
        comp[n] = best
    return comp

MAXN = 2000
comp = integer_complexity(MAXN)

def berry_number(k):
    """1을 k개로는 못 만드는(=복잡도가 k 초과인) 가장 작은 수."""
    return next(n for n in range(1, MAXN + 1) if comp[n] > k)

budget = 11
target = berry_number(budget)                  # 41

fig, (axL, axR) = plt.subplots(1, 2, figsize=(13, 6.0))
fig.patch.set_facecolor(DARK)

# (왼쪽) 복잡도 막대 + 예산선 + 첫 미달성 수
style(axL)
ns = np.arange(1, 81)
vals = [comp[n] for n in ns]
bar_colors = [RED if n == target else (GREY if comp[n] > budget else BLUE) for n in ns]
axL.bar(ns, vals, width=0.9, color=bar_colors, edgecolor="none")
axL.axhline(budget, color=ORANGE, ls="--", lw=2.2)
axL.text(2, budget + 0.25, L(f"예산: 1을 {budget}개", f"budget: {budget} ones"),
         color=ORANGE, fontsize=11, fontweight="bold")
axL.annotate(L(f"{budget}개로는 못 만드는\n가장 작은 수 = {target}",
               f"smallest one you can't\nbuild with {budget} ones = {target}"),
             xy=(target, comp[target]), xytext=(4.5, 13.1),
             color=RED, fontsize=10.5, fontweight="bold",
             arrowprops=dict(arrowstyle="-|>", color=RED, lw=1.6))
axL.set_xlabel(L("수 n", "integer n"))
axL.set_ylabel(L("최소한 필요한 1의 개수", "fewest 1's needed"))
axL.set_title(L("장난감 언어에서 각 수의 '설명 길이'", "Description length in the toy language"),
              fontsize=12.5, loc="left", color=LIGHT)
axL.set_xlim(0, 81); axL.set_ylim(0, 15.5)

# (오른쪽) 예산마다 베리의 수는 하나씩, 모순 없이 — 그리고 빠르게 커진다
style(axR)
ks = list(range(1, 16))
Nk = [berry_number(k) for k in ks]
axR.plot(ks, Nk, "o-", color=ORANGE, lw=2.4, ms=6)
axR.set_yscale("log")
i11 = ks.index(budget)                                  # 왼쪽 그림(예산 11 -> 41)과 잇기
axR.scatter([budget], [Nk[i11]], color=RED, s=95, zorder=6, edgecolors=LIGHT)
axR.annotate(L(f"예산 {budget} → {Nk[i11]}\n(왼쪽 그림의 그 수)", f"budget {budget} → {Nk[i11]}"),
             xy=(budget, Nk[i11]), xytext=(11.4, 9.5), color=RED, fontsize=10,
             fontweight="bold", arrowprops=dict(arrowstyle="-|>", color=RED, lw=1.4))
axR.text(1.2, Nk[-1] * 1.0,
         L("예산이 1씩 커질 때마다\n베리의 수는 껑충 뛰어오른다.\n하지만 그것을 가리키는\n우리말 문장은 늘 한 줄.",
           "as the budget grows by 1,\nthe Berry number leaps up —\nbut the phrase that names it\nstays one line"),
         color=GREEN, fontsize=10.5, fontweight="bold", va="top")
axR.set_xlabel(L("예산 k (허락된 1의 개수)", "budget k (allowed ones)"))
axR.set_ylabel(L("그 예산으로는 못 만드는 가장 작은 수", "smallest number you can't build"))
axR.set_title(L("예산마다 베리의 수가 하나씩, 모순 없이", "One Berry number per budget — no contradiction"),
              fontsize=12.5, loc="left", color=LIGHT)
axR.set_xlim(0, 16)

print("장난감 언어(1과 +,×만, 길이는 쓴 1의 개수)에서:")
print(f"  6  = (1+1)x(1+1+1)            -> 1을 {comp[6]}개")
print(f"  10 = (1+1)x(1+1+1+1+1)        -> 1을 {comp[10]}개")
print(f"  41 = ...                       -> 1을 {comp[41]}개")
print(f"\n'1을 {budget}개 이하로는 결코 못 만드는 가장 작은 수' = {target}")
print("그런데 우리는 방금 그 수를, 이렇게 우리말 한 문장으로 가리켰다 (모순 없음!).")
print("\n예산별로 찾은 '베리의 수':")
for k in [5, 8, 11, 14]:
    print(f"  1을 {k}개로는 못 만드는 가장 작은 수 = {berry_number(k)}")

fig.suptitle(L("장난감 언어로 베리의 수를 직접 잡아 보다",
               "Catching a Berry Number in a Toy Language"),
             color=LIGHT, fontsize=15.5, fontweight="bold")
fig.tight_layout(rect=[0, 0, 1, 0.95])
plt.show()
장난감 언어(1과 +,×만, 길이는 쓴 1의 개수)에서:
  6  = (1+1)x(1+1+1)            -> 1을 5개
  10 = (1+1)x(1+1+1+1+1)        -> 1을 7개
  41 = ...                       -> 1을 12개

'1을 11개 이하로는 결코 못 만드는 가장 작은 수' = 41
그런데 우리는 방금 그 수를, 이렇게 우리말 한 문장으로 가리켰다 (모순 없음!).

예산별로 찾은 '베리의 수':
  1을 5개로는 못 만드는 가장 작은 수 = 7
  1을 8개로는 못 만드는 가장 작은 수 = 17
  1을 11개로는 못 만드는 가장 작은 수 = 41
  1을 14개로는 못 만드는 가장 작은 수 = 89
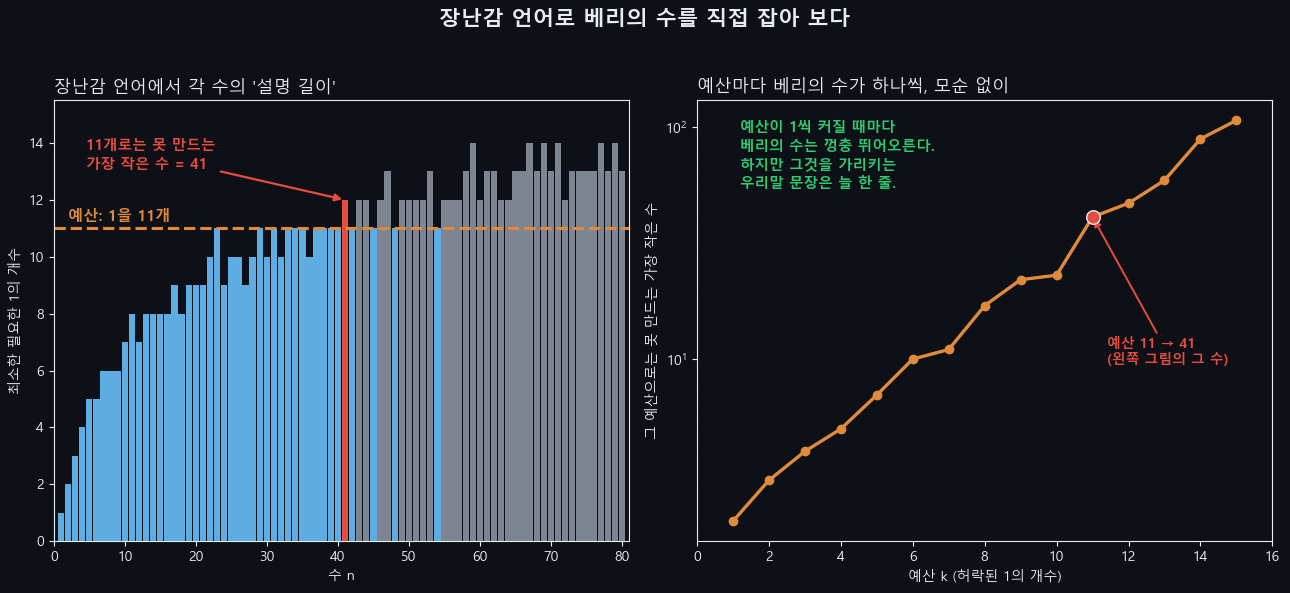
왼쪽 그림에서 막대 하나하나가 “그 수를 만드는 데 필요한 최소한의 1의 개수"입니다. 들쭉날쭉하지만 큰 흐름은 우상향이지요. 주황 점선은 “1을 열한 개"라는 예산이고, 이 선을 처음으로 뚫고 올라온 빨간 막대가 바로 41 입니다. 즉 1을 열한 개 이하로 아무리 영리하게 엮어도 결코 41은 만들 수 없습니다. 41이야말로 이 장난감 언어에서 “1을 열한 개로는 못 만드는 가장 작은 수” 입니다. 컴퓨터가 모든 조합을 뒤져 정확히 찾아냈고, 어떤 모순도 일어나지 않았습니다.
여기서 잠깐 멈춰 봅시다. 우리는 방금 그 수를 “1을 열한 개로는 못 만드는 가장 작은 수” 라는 짤막한 우리말 한 문장으로 가리켰습니다. 서론의 그 어지러움이 또 도지려나요? 아닙니다. 그리고 바로 여기에 역설을 푸는 열쇠가 있습니다.
오른쪽 그림이 그 열쇠로 가는 길을 깔아 줍니다. 예산을 하나씩 키워 가며 그때그때의 베리의 수를 찍어 본 건데, 보다시피 모순으로 폭발하기는커녕 예산마다 베리의 수가 정확히 하나씩, 얌전하게 정해집니다. 다만 그 수는 예산이 조금만 커져도 껑충껑충 뛰어 금세 수십, 수백이 되지요. 그런데 그렇게 커진 수들을 가리키는 우리말 문장은 어떤가요? “예산 몇 개로는 못 만드는 가장 작은 수” — 길이가 늘 그대로, 한 줄입니다. 짧은 문장 하나가 얼마든지 크고 복잡한 수를 콕 집어낼 수 있다는 것. 바로 이 힘이 일상 언어에서는 역설의 방아쇠가 됩니다. 그런데 이 장난감 언어에서는 왜 안전할까요?
핵심은 두 언어가 서로 다른 언어라는 데 있습니다. 우리가 “1을 열한 개로는 못 만드는 가장 작은 수"라고 말할 때, 이 문장은 우리말(설명하는 언어, 메타언어) 로 쓰인 것이지, 1과 +, ×로만 이루어진 장난감 언어(설명되는 언어, 대상언어) 로 쓰인 게 아닙니다. 41이 “장난감 언어로는 길다(1이 열두 개나 든다)“는 것과 “우리말로는 짧다(한 문장이면 된다)“는 것은 전혀 부딪치지 않습니다. 키를 센티미터로 재면 173, 인치로 재면 68인 것이 모순이 아닌 것과 똑같지요. 서로 다른 자로 잰 값을 나란히 놓고 “어, 모순이네?” 하는 게 그 어지러움의 정체였던 겁니다.
그렇다면 서론의 베리 문장은 왜 모순이었을까요? 거기서는 설명하는 언어와 설명되는 언어가 둘 다 똑같은 한국어였기 때문입니다. “스무 글자로 설명한다"의 글자도 한국어 글자고, 그걸 설명하는 문장도 한국어 문장이라, 자가 자기 자신을 재는 일이 벌어진 거지요. 자가 자기 길이를 재기 시작하면 이런 어지러움이 생깁니다.
장난감 언어처럼 “설명하는 언어"와 “설명되는 언어"를 분리해 두면 역설은 깔끔하게 사라집니다. 일상 언어가 위험한 건, 그 둘이 한 몸이라 자기 자신의 ‘설명 가능성’을 자기 안에서 떠들 수 있기 때문입니다.
이건 그냥 말장난을 피하는 요령이 아니라, 20세기 논리학이 도달한 진짜 결론이기도 합니다(아래 5장에서 다시 만납니다). 우선은 이 장난감 언어가 보여 준 더 충격적인 사실 하나를 보고 가겠습니다. 41은 빙산의 일각이라는 것 말입니다.
4. 빙산의 일각: 거의 모든 수에는 이름이 없다
3장에서 본 “두 언어를 분리하라"는 해법은 깔끔합니다. 하지만 “일상 언어가 좀 엉성해서 그래"라고 정리하고 덮어 버리기엔 어딘가 아쉽지요. 사실 이 역설에는 한 겹 더 깊은 속살이 있습니다. 그리고 바로 거기서, 도서관 사서의 말장난은 현대 컴퓨터 과학의 심장부와 만납니다.
2장의 세기 논증을 다시 떠올려 봅시다. 짧은 이름은 유한개, 수는 무한개. 우리는 거기서 “이름 없는 수가 적어도 하나는 있다"는 결론만 챙겼습니다. 그런데 사실 그 논증은 훨씬 더 센 말을 하고 있었습니다. 이름표가 유한개뿐이라면, 이름을 받는 수는 전체의 티끌일 수밖에 없고, 거의 모든 수는 짧은 이름을 못 받습니다. 베리의 수는 그 거대한 무명(無名)의 바다에서 그저 “가장 먼저 떠오른” 봉우리 하나였을 뿐입니다.
이쯤 되면 “어떤 수의 가장 짧은 설명의 길이"라는 양 자체가 궁금해집니다. 어떤 수는 “1 다음에 0을 백 개"처럼 한 줄로 끝나는데, 어떤 수는 자릿수를 통째로 불러 주는 것 말고는 더 줄일 방법이 없습니다. 이 “가장 짧은 설명의 길이"에는 어엿한 이름이 있습니다. 콜모고로프 복잡도(Kolmogorov complexity). 풀어 말하면 “그 대상을 만들어 내는 가장 짧은 설명서(프로그램)의 길이"입니다. 짧게 설명되면 복잡도가 낮고, 줄일 길이 없으면 복잡도가 높습니다.
컴퓨터로 이 분위기를 흉내 내 봅시다. “가장 짧은 설명"을 정확히 구하는 건 (곧 보겠지만) 불가능하지만, 압축 프로그램이 줄여 준 길이를 그 어림짐작으로 쓸 수 있습니다. 잘 압축되면 그 수에는 “짧은 설명이 있다"는 꽤 믿을 만한 신호가 되거든요. (반대로 “잘 안 줄어드니 짧은 설명이 아예 없다"고 곧장 단정하면 안 되는데, 그 미묘한 대목은 그림을 본 뒤에 따로 짚겠습니다.)
파이썬 코드 보기 (펼치기 / 접기)
import numpy as np
import zlib
import matplotlib.pyplot as plt
from matplotlib.ticker import FixedLocator, FixedFormatter
import matplotlib.font_manager as fm
# 한글 차트용 폰트 자동 등록(윈도우=맑은 고딕). 없으면 라벨을 영어로 폴백(두부 방지, OS 이식성).
_has_kr, KFONT = False, "DejaVu Sans"
for _fp in [r"C:\Windows\Fonts\malgun.ttf",
            "/System/Library/Fonts/AppleSDGothicNeo.ttc",
            "/usr/share/fonts/truetype/nanum/NanumGothic.ttf"]:
    try:
        fm.fontManager.addfont(_fp)
        KFONT = fm.FontProperties(fname=_fp).get_name()
        plt.rcParams["font.family"] = KFONT
        _has_kr = True
        break
    except Exception:
        continue
plt.rcParams["axes.unicode_minus"] = False
def L(ko, en):
    return ko if _has_kr else en

DARK, LIGHT = "#0d1117", "#e6edf3"
BLUE, ORANGE, YELLOW, GREY, RED, GREEN = "#5dade2", "#e08a3c", "#f1c40f", "#7d8590", "#e74c3c", "#2ecc71"

def style(ax):
    ax.set_facecolor(DARK)
    for sp in ax.spines.values():
        sp.set_color(LIGHT)
    ax.tick_params(colors=LIGHT, labelsize=10)
    ax.xaxis.label.set_color(LIGHT); ax.yaxis.label.set_color(LIGHT)

def comp_bits(b):
    return len(zlib.compress(b, 9)) * 8        # 압축 후 길이(비트) = '짧은 설명'의 어림값

RAW_BYTES = 150
RAW_BITS = RAW_BYTES * 8                        # 1200비트로 길이를 통일해 공정 비교
rng = np.random.default_rng(7)

samples = [
    (L("모두 0\n00000…0", "all zeros"),            bytes(RAW_BYTES)),
    (L("규칙 반복\n0101…", "periodic 0101"),        bytes([0xAA]) * RAW_BYTES),
    (L("짧은 규칙\n123 123…", "short rule 123…"),   bytes([1, 2, 3]) * (RAW_BYTES // 3)),
    (L("무작위 수\n(규칙 없음)", "random number"),   rng.integers(0, 256, RAW_BYTES, dtype=np.uint8).tobytes()),
]

fig, (axL, axR) = plt.subplots(1, 2, figsize=(13, 6.0))
fig.patch.set_facecolor(DARK)

# (왼쪽) 같은 길이의 수들을 압축 — 규칙 있으면 쪼그라들고, 무작위면 안 줄어든다
style(axL)
names = [s[0] for s in samples]
cbits = [comp_bits(s[1]) for s in samples]
xs = np.arange(len(samples))
colors = [GREEN, GREEN, BLUE, RED]
axL.axhline(RAW_BITS, color=GREY, ls="--", lw=1.8)
axL.text(-0.38, RAW_BITS + 28, L("원래 길이 1200비트", "original 1200 bits"),
         color=GREY, fontsize=10, ha="left")
axL.bar(xs, cbits, width=0.62, color=colors, edgecolor=LIGHT)
for x, v in zip(xs, cbits):
    axL.text(x, v + 35, f"{v}", ha="center", color=LIGHT, fontweight="bold", fontsize=11)
axL.set_xticks(xs); axL.set_xticklabels(names, color=LIGHT, fontsize=9.5)
axL.set_ylabel(L("가장 짧은 설명의 길이 (비트, 어림값)", "shortest description (bits, estimate)"))
axL.set_ylim(0, RAW_BITS * 1.18)
axL.set_title(L("규칙(=짧은 이름)이 있는 수만 쪼그라든다", "Only numbers with a rule shrink"),
              fontsize=12.5, loc="left", color=LIGHT)

# (오른쪽) 세기 논증의 재림: 거의 아무 수도 못 줄인다
style(axR)
cs = np.arange(0, 13)
frac = 0.5 ** cs                                # n비트 수 중 c비트 이상 줄어드는 것의 비율 <= 2^-c
axR.bar(cs, frac, width=0.7, color=ORANGE, edgecolor=LIGHT)
axR.set_yscale("log")
axR.set_ylim(1e-4, 2.0)
axR.yaxis.set_major_locator(FixedLocator([1, 1e-1, 1e-2, 1e-3, 1e-4]))
axR.yaxis.set_major_formatter(FixedFormatter(
    [L("1 (전부)", "1"), "1/10", "1/100", "1/1000", "1/10000"]))
axR.yaxis.set_minor_locator(FixedLocator([]))
notes = {1: L("1비트 이상 줄어드는 수\n: 많아야 절반(50%)", ">=1 bit saved: <= 50%"),
         10: L("10비트 이상 줄어드는 수\n: 1000개에 1개꼴(약 0.1%)", ">=10 bits saved: ~0.1%")}
for c in [1, 10]:
    axR.annotate(notes[c],
                 xy=(c, frac[c]), xytext=(c + 0.5, frac[c] * (14 if c == 1 else 80)),
                 color=YELLOW, fontsize=10, fontweight="bold",
                 arrowprops=dict(arrowstyle="-|>", color=YELLOW, lw=1.3))
axR.set_xlabel(L("줄이고 싶은 길이 c (비트)", "bits c you hope to save"))
axR.set_ylabel(L("그만큼 줄어드는 수의 최대 비율", "max fraction that shrinks that much"))
axR.set_title(L("'짧은 이름'은 처음부터 모자란다", "Short names are scarce from the start"),
              fontsize=12.5, loc="left", color=LIGHT)

print("같은 길이(1200비트)의 수들을 압축해 본 결과:")
for (nm, b) in samples:
    print(f"  {nm.splitlines()[0]:<12}: 1200비트 -> {comp_bits(b):>5}비트")
print("  (무작위 수는 오히려 늘기도 한다 — 줄일 규칙이 없기 때문)")
print("\n수학적 사실: n비트 수 가운데 c비트 이상 줄일 수 있는 것은 많아야 2^(-c)이다.")
print("  c=1  -> 많아야 50%   (절반은 단 1비트도 못 줄인다)")
print("  c=10 -> 많아야 0.1%  (99.9%는 10비트도 못 줄인다)")
print("  => 거의 모든 수에는 짧은 이름이 없다. 베리의 수는 빙산의 일각일 뿐.")

fig.suptitle(L("거의 모든 수에는 짧은 이름이 없다",
               "Almost Every Number Has No Short Name"),
             color=LIGHT, fontsize=15.5, fontweight="bold")
fig.tight_layout(rect=[0, 0, 1, 0.95])
plt.show()
같은 길이(1200비트)의 수들을 압축해 본 결과:
  모두 0        : 1200비트 ->    96비트
  규칙 반복       : 1200비트 ->    96비트
  짧은 규칙       : 1200비트 ->   112비트
  무작위 수       : 1200비트 ->  1288비트
  (무작위 수는 오히려 늘기도 한다 — 줄일 규칙이 없기 때문)

수학적 사실: n비트 수 가운데 c비트 이상 줄일 수 있는 것은 많아야 2^(-c)이다.
  c=1  -> 많아야 50%   (절반은 단 1비트도 못 줄인다)
  c=10 -> 많아야 0.1%  (99.9%는 10비트도 못 줄인다)
  => 거의 모든 수에는 짧은 이름이 없다. 베리의 수는 빙산의 일각일 뿐.
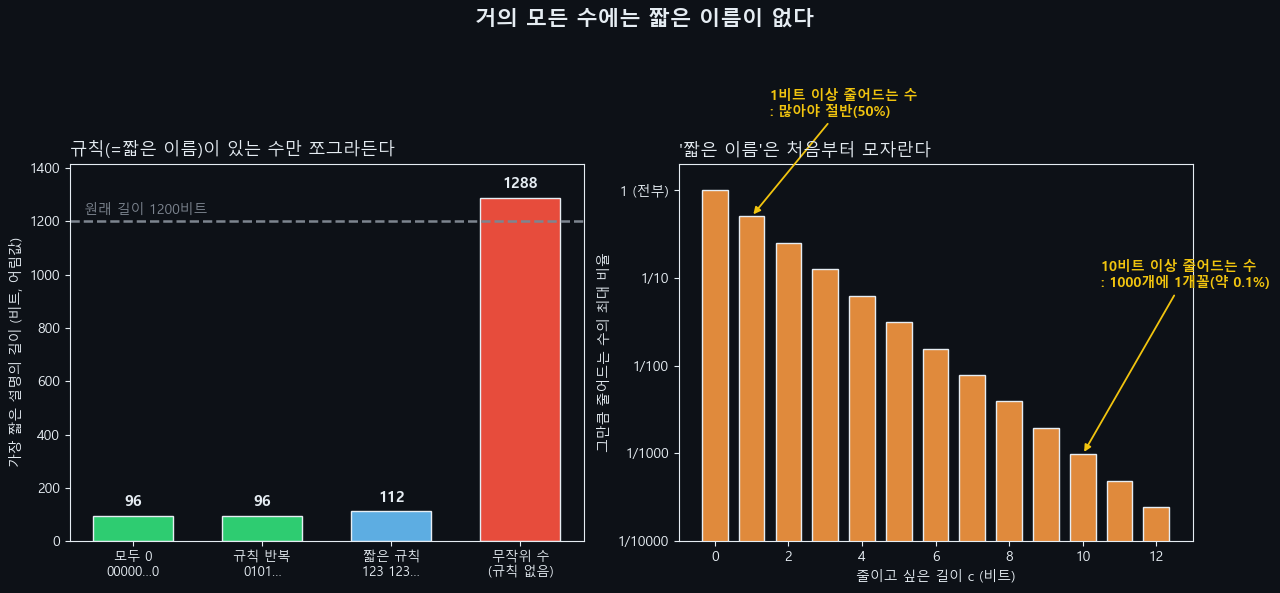
왼쪽 그림은 길이가 똑같은(1200비트짜리) 수 네 개를 압축해 본 것입니다. “모두 0"이나 “규칙 반복"처럼 짧은 규칙이 있는 수는 압축기가 한순간에 손바닥만 하게 줄여 버립니다 — 짧은 이름이 있다는 뜻이지요. 반대로 맨 오른쪽 무작위 수는 거의 그대로거나 외려 살짝 늘어납니다. 줄여 줄 규칙이 아예 없으니 “원래 그 길이가 가장 짧은 설명"인 셈입니다.
오른쪽 그림이 이 장의 핵심이고, 사실은 2장의 세기 논증이 옷만 갈아입고 다시 나타난 것입니다. n비트짜리 수 가운데 ‘c비트 이상 줄일 수 있는’ 수의 비율은 많아야 절반의 절반의 절반…, 정확히 2분의 1을 c번 곱한 값밖에 안 됩니다. 이유는 똑같습니다. 짧은 설명서(짧은 비트열)는 개수가 적으니까요. 그래서 어떤 수의 절반은 단 1비트도 못 줄이고, 99.9퍼센트는 10비트조차 못 줄입니다. 압축이 잘되는 수, 짧은 이름이 있는 수가 오히려 희귀한 예외라는 겁니다.
우리는 보통 정반대로 느낍니다. 떠올리는 수마다 죄다 그럴듯한 규칙이 있어 보이지요. 하지만 그건 우리가 규칙 있는 수만 떠올리기 때문입니다. 무작위한 수는 부를 이름조차 없어서 애초에 우리 머릿속에 잘 떠오르지도 않는 거고요. 베리의 수는 이 거대한 무명의 바다에서 그저 가장 앞에 선 봉우리였을 뿐입니다.
잠깐, 짚고 갈 것: zlib이 못 줄였다고 '복잡한 수'인 건 아니다 (선택)
방금 우리는 압축기를 ‘짧은 이름’의 측정기처럼 썼지만, 여기엔 정직하게 짚고 갈 틈이 하나 있습니다. zlib 같은 흔한 압축기는 사실 ‘통계적인’ 규칙만 봅니다. 같은 바이트가 반복되거나(예: 0000…), 특정 기호가 유독 자주 나오거나 하는 빈도 패턴을 찾아 줄이는 식이지요(정보이론에서 섀넌 엔트로피라 부르는, 출현 빈도에 기댄 압축입니다).
그런데 ‘짧은 이름’의 진짜 정의인 콜모고로프 복잡도는 그보다 훨씬 너그럽습니다. 그 수를 뱉어내는 가장 짧은 프로그램이면 무엇이든 이름으로 쳐 주거든요. 대표적인 반례가 원주율 $\pi$ 입니다. $\pi$의 소수점 아래를 1,200비트만큼 떼어 zlib에 넣으면, 통계적 규칙이라곤 없어서 우리 그림의 ‘무작위 수’처럼 거의 안 줄어듭니다. 하지만 $\pi$는 결코 무작위한 수가 아니지요. “원주율을 계산해 자릿수를 차례로 뱉어라"라는 짧은 프로그램 하나면 얼마든지 길게 찍어낼 수 있으니, 콜모고로프 복잡도로 보면 $\pi$는 오히려 아주 단순한 수입니다($\sqrt{2}$ 도 마찬가지고요).
그러니 정확히 말하면 이렇습니다. 압축기가 줄여 주면 “짧은 이름이 있다"는 확실한 증거가 됩니다(그만큼 짧은 설명서를 실제로 찾았으니까요). 하지만 줄여 주지 못한다고 “짧은 이름이 없다"가 보장되는 건 아닙니다. zlib의 압축률은 진짜 복잡도의 한쪽 어림값, 곧 상한일 뿐이고, 그 사이에는 정보이론의 ‘엔트로피’와 알고리즘 정보이론의 ‘복잡도’를 가르는 미묘한 경계가 있습니다. 우리 그림은 그 경계의 한쪽 면 — ‘통계적으로 규칙 있는 수는 드물다’ — 을 보여 준 것이고, 그것만으로도 베리의 직관(짧은 이름은 귀하다)을 손에 쥐기엔 충분합니다.
조금 더 깊이: 왜 '가장 짧은 설명'은 컴퓨터로도 구할 수 없는가 (선택)
여기서 한 걸음만 더 들어가면, 베리의 역설이 20세기 수학의 가장 깊은 결과들과 곧장 맞닿습니다. 어떤 수의 “가장 짧은 설명의 길이"를 $K$ 라고 부릅시다(콜모고로프 복잡도).
(1) $K$ 는 계산할 수 없습니다. 그리고 그 증명이 바로 베리의 역설 그 자체입니다. 만약 $K$ 를 계산해 주는 프로그램이 있다고 해 봅시다. 그러면 “복잡도가 $n$ 보다 큰 첫 번째 수를 찾아 내놓아라"라는 프로그램을 짤 수 있습니다. 그런데 이 프로그램의 길이는 고작 ‘$n$ 을 적는 데 드는 길이(약 $\log n$)’ + ‘고정된 짧은 검색 절차’뿐이라, $n$ 이 조금만 커지면 $n$ 보다 한참 짧습니다. 즉 이 짧은 프로그램이 “복잡도가 $n$ 보다 큰 수"를 $n$ 보다 짧게 설명해 버립니다. 모순이지요. 빠져나갈 길은 단 하나, 처음 가정이 틀렸다는 것 — $K$ 는 계산 불가능합니다. 서론의 베리 문장에서 ‘설명 가능’을 ‘짧은 프로그램으로 출력 가능’이라는 칼같은 말로 바꾸면, 말장난이 어엿한 정리로 굳어집니다.
(2) 그래서 어떤 수가 ‘진짜 복잡하다’는 건 증명조차 할 수 없습니다. 1970년대에 그레고리 차이틴(Gregory Chaitin) 이 보인 것이 이겁니다. 어떤 수학 체계든, 그 체계에는 자신의 덩치에 따라 정해지는 어떤 한계 숫자 $L$ 이 있어서, “이 수의 복잡도는 $L$ 보다 크다"는 명제를 어느 특정한 수에 대해서도 결코 증명할 수 없습니다. 거의 모든 수가 실제로는 그 조건을 만족하는데도 말입니다. 수학이 “이 수는 정말로 줄일 수 없이 복잡하다"고 콕 집어 말하지 못하는, 명백한 한계선이 그어져 있는 셈입니다.
(3) 그런데 어떻게 ‘말장난’이 수학 정리가 되었나 — 괴델 수라는 다리. 여기서 한 가지가 꼭 걸립니다. 베리든 거짓말쟁이든 분명 ‘말’에 관한 역설인데, 숫자와 덧셈·곱셈만 아는 차가운 수학 체계가 어떻게 이런 말장난에 발목을 잡힐까요? 순수한 수학은 본래 “이 문장"이라거나 “증명할 수 없다” 같은 말을 입에 담을 줄 모르는데 말입니다. 이 틈을 메운 결정적 한 수가 1931년 괴델의 괴델 수(Gödel numbering) 입니다. 모든 기호와 논리식에 (소인수분해를 이용해) 고유한 번호를 붙여 문장을 통째로 하나의 숫자로 암호화하면, “숫자에 관한 수학 공식"이 곧 “문장에 관한 논리적 평가"가 되는 거울이 생깁니다. 자기 자신을 가리키던 말장난이, 바로 이 거울을 통해 한 치의 손실도 없이 수식의 세계로 건너오는 것이지요.
(4) 그렇게 괴델의 불완전성 정리까지. 괴델은 그 거울 안에서 “나는 증명될 수 없다"고 말하는 수식을 지어내 불완전성 정리를 세웠고, 1989년 조지 불로스(George Boolos) 는 같은 다리를 건너 이번엔 베리의 역설을 정식 논리로 옮겨, 괴델의 제1 불완전성 정리(어떤 충분히 강한 수학 체계에도 참이지만 증명할 수 없는 명제가 있다)를 단 두 쪽 만에 새로 증명했습니다. 괴델의 원래 증명이 “이 문장은 증명할 수 없다"는 거짓말쟁이류 자기지시를 썼다면, 불로스는 “짧게 설명할 수 없는 수"라는 베리류 자기지시를 쓴 겁니다. 도서관 사서의 말장난이, 숫자라는 거울을 거쳐, 수학에는 자신이 증명하지 못하는 진리가 반드시 있다는 그 위대한 정리의 한 증명으로 자란 것이지요.
5. 자기를 가리키는 문장들의 가족
베리의 역설은 혼자가 아닙니다. “자기 자신을 가리키는 말"이라는 한 가족의 일원이고, 이 가족을 한자리에 모아 보면 베리가 어디쯤 서 있는지가 또렷해집니다.
- 거짓말쟁이의 역설: “이 문장은 거짓이다.” 가장 오래된 맏형입니다. 참이라면 거짓이고 거짓이라면 참이라, 영원히 제자리를 맴돕니다.
- 그렐링-넬슨의 역설: “자기 자신에게 들어맞지 않는 형용사"를 생각해 봅시다(예를 들어 ‘짧다’는 짧은 단어가 아니니 자기 자신에게 안 맞지요). 그렇다면 “자기 자신에게 안 맞는"이라는 말 자체는 자기 자신에게 맞을까요, 안 맞을까요? 베리와 똑 닮은, 말이 자기를 무는 구조입니다.
- 리샤르의 역설: 베리보다 한 해 앞선 1905년, 프랑스 수학자 쥘 리샤르(Jules Richard) 가 내놓은 더 정교한 사촌입니다. “말로 정의할 수 있는 모든 소수(小數)“를 죽 늘어놓고, 칸토어의 대각선 논법으로 “그 목록 어디에도 없는 새 수"를 또 말로 정의해 버리는, 베리와 똑같은 덫이지요. 실제로 괴델은 1931년 자신의 불완전성 논문에서 이 리샤르의 역설을 자기 증명의 길잡이로 명시적으로 언급했습니다.
- 흥미로운 수의 역설: “흥미롭지 않은 수"가 있다고 해 봅시다. 그렇다면 그중 가장 작은 수가 있을 텐데, “가장 작은 흥미롭지 않은 수"라는 사실 자체가 어쩐지 흥미롭습니다. 그래서 그 수는 흥미로워지고, 모순이 됩니다 — 결국 모든 수가 흥미롭다는 우스개 증명이지요. ‘흥미롭다’를 ‘짧게 설명된다’로 바꾸면 곧장 베리가 됩니다.
- 튜링의 정지 문제: 이 가족의 막내는 말이 아니라 프로그램이 자기를 뭅니다. 1936년 앨런 튜링은 “어떤 프로그램이 언젠가 멈출지, 아니면 영원히 돌지를 미리 판별해 주는 만능 프로그램"이 존재할 수 없음을 증명했는데, 그 방법이 베리·리샤르와 판박이인 자기지시였습니다. 그런 만능 판별기가 있다고 치고, 그 판별기의 답을 받아 일부러 정반대로 행동하는(멈춘다고 하면 영영 돌고, 안 멈춘다고 하면 즉시 멈추는) 삐딱한 프로그램을 만들어 자기 자신에게 먹이면 — 판별기는 어느 쪽으로도 답할 수 없게 됩니다. “이 문장은 거짓이다"가 프로그램의 옷을 입은 셈이지요.
이 가족의 공통점은 하나입니다. ‘참이다’, ‘정의할 수 있다’, ‘흥미롭다’, ‘언젠가 멈춘다’ 같은 판정이, 자기가 속한 바로 그 체계 안에서 자기 자신을 평가하려 들 때 사달이 난다는 것.
3장에서 우리는 장난감 언어로 그 처방을 미리 맛봤습니다. “설명하는 언어(메타언어)“와 “설명되는 언어(대상언어)“를 분리하면 역설이 사라진다고요. 이건 단순한 요령이 아니라 1930년대에 알프레트 타르스키(Alfred Tarski) 가 정리로 못 박은 사실입니다. 이른바 진리 정의불가능성 정리: 충분히 풍부한 언어는 자기 자신의 ‘참’이나 ‘정의 가능성’을 자기 안에서 정의할 수 없습니다. 그걸 말하려면 한 단계 위, 더 표현력 있는 언어로 올라가야 하지요. 베리·리샤르·거짓말쟁이가 일상 언어에서 어지럼증을 일으킨 건, 일상 언어가 겁도 없이 자기 자신을 평가하는 — 타르스키의 표현으로 “의미론적으로 닫힌” — 언어이기 때문이었습니다. 도서관 사서의 한 줄짜리 수수께끼가, 결국 “언어는 자기 자신을 온전히 말할 수 없다"는 깊은 통찰의 입구였던 셈입니다.
그리고 바로 이 지점에서, 한 도서관 사서의 말장난은 컴퓨터 과학의 가장 근본적인 한계와 포개집니다. 자기 자신을 가리키는 문장이 일으킨 그 모순이, 튜링의 손에서는 “어떤 소프트웨어도 모든 프로그램의 운명을 미리 알 수는 없다” 는 정지 문제로 자라났으니까요. 무한 호텔에서 출발해 칸토어의 대각선 논법을 거쳐 튜링의 정지 문제에 닿는 이 여정은 이 블로그의 ‘힐베르트 호텔’ 편에 따로 풀어 두었는데, 베리의 역설은 바로 그 여정과 한 핏줄입니다. 한쪽에서는 “스무 글자로 설명할 수 없는 수"가, 다른 쪽에서는 “멈출지 멈추지 않을지 알 수 없는 프로그램"이 — 똑같은 자기지시의 그림자를 드리우고 있는 거지요.
6. 마무리: 자를 자로 재지 마세요
다시 처음의 그 한 문장으로 돌아가 봅시다. “스무 글자로는 설명할 수 없는 가장 작은 수.” 이제 우리는 이 문장의 어디가 멀쩡하고 어디가 함정이었는지 압니다.
- 그런 수는 진짜로 있습니다. 짧은 이름은 유한개, 수는 무한개. 그러니 이름 없는 수가 반드시 남고, 그중 가장 작은 수도 분명히 있습니다(2장). 여기까지는 한 점 흠이 없습니다.
- 모순은 그 수를 ‘가리키는 방식’에서 났습니다. “설명 가능"이라는 잣대를, 그 잣대가 속한 바로 그 언어 안에서 자기 자신에게 휘두른 순간, 자가 제 길이를 재기 시작한 겁니다(3장).
- 처방은 자와 잴 대상을 분리하는 것입니다. 장난감 언어처럼 “설명하는 언어"와 “설명되는 언어"를 떼어 놓으면 어지럼증은 깨끗이 사라집니다(3장, 5장).
오늘 우리가 쓴 도구를 되짚어 보면 정말 별것 없습니다. 개수를 세는 일, 그리고 “이 말은 대체 어느 언어로 하는 말인가"를 한 번 묻는 일. 그 사소한 두 가지가, 한쪽에서는 “거의 모든 수에는 짧은 이름이 없다"는 사실(4장)을, 다른 쪽에서는 “가장 짧은 설명은 컴퓨터로도 못 구한다”, 나아가 “수학에는 자신이 증명하지 못하는 진리가 반드시 있다"는 거대한 결과(4장 심화)를 길어 올렸습니다.
베리의 역설이 아름다운 이유는, 누구를 골탕 먹이는 말장난처럼 보이면서도 사실은 언어와 수의 가장 예민한 급소를 정확히 찌르기 때문입니다. 그러니 다음에 “그건 한마디로 정의할 수 있어"라거나 “그 수에는 분명 무슨 의미가 있어” 같은 말을 마주치거든, 한 번쯤 이렇게 되물어 보시면 어떨까요. 지금 이 잣대는, 혹시 자기 자신을 재고 있지는 않은가? 그 한 번의 물음이, 어지러운 역설을 담담한 산수로 바꿔 줍니다. 100여 년 전 한 도서관 사서가 편지지 위에서 발견했던, 바로 그 산수로 말입니다.
참고문헌
- Russell, B. (1908). Mathematical Logic as Based on the Theory of Types. American Journal of Mathematics, 30(3), 222–262. (베리의 역설과 “the least integer not nameable in fewer than nineteen syllables … it denotes 111,777”, G. G. Berry에게 공을 돌린 각주)
- Russell, B. (1906). Les paradoxes de la logique. Revue de métaphysique et de morale, 14, 627–650. (베리의 역설이 처음 활자화된 글; 영어 원제 “On ‘Insolubilia’ and Their Solution by Symbolic Logic”)
- Richard, J. (1905). Les principes des mathématiques et le problème des ensembles. Revue générale des sciences pures et appliquées, 16. (리샤르의 역설, 1905)
- Tarski, A. (1933/1936). Pojęcie prawdy w językach nauk dedukcyjnych / Der Wahrheitsbegriff in den formalisierten Sprachen. (진리 정의불가능성 정리)
- Gödel, K. (1931). Über formal unentscheidbare Sätze der Principia Mathematica und verwandter Systeme I. (불완전성 정리; 리샤르의 역설을 의미론적 길잡이로 언급)
- Turing, A. M. (1936). On Computable Numbers, with an Application to the Entscheidungsproblem. Proceedings of the London Mathematical Society, s2-42, 230–265. (정지 문제·결정 불가능성을 대각선 논법 기반 자기지시로 증명)
- Boolos, G. (1989). A New Proof of the Gödel Incompleteness Theorem. Notices of the American Mathematical Society, 36, 388–390. (베리의 역설을 정식화해 제1 불완전성 정리를 재증명)
- Chaitin, G. J. (1999). The Unknowable. Springer. (콜모고로프 복잡도 기반 불완전성; 베리의 역설과 베리의 원래 편지에 관한 일화)
- Kolmogorov, A. N. (1965). Three Approaches to the Quantitative Definition of Information. Problems of Information Transmission, 1(1), 1–7. (콜모고로프 복잡도; Solomonoff 1964, Chaitin 1966와 독립적으로)
- “Berry paradox”, “Richard’s paradox”, “Tarski’s undefinability theorem”, “Kolmogorov complexity”, “Interesting number paradox” — Wikipedia / Stanford Encyclopedia of Philosophy (Self-Reference; Paradoxes and Contemporary Logic) / PlanetMath / Wolfram MathWorld. (대중적 서술과 출처 대조)
- 정수 복잡도(integer complexity): OEIS A005245 (1과 +, ×로 n을 만드는 최소 1의 개수).